Lo ideal sería ejecutar modelos de IA sin conexión, pero generalmente requiere hardware potente y costoso. Sin embargo, no siempre es así: el modelo DeepSeek R1 ofrece una opción práctica para dispositivos con capacidades limitadas y además es increíblemente fácil de instalar.

Enlaces rápidos
¿Qué significa ejecutar un chatbot de IA localmente?
Cuando utiliza chatbots de inteligencia artificial en línea como ChatGPT, sus solicitudes se procesan en los servidores de OpenAI, lo que significa que su dispositivo no hace el trabajo pesado. Necesita una conexión a Internet constante para comunicarse con los chatbots de IA y nunca tendrá control total sobre sus datos. Los modelos de lenguaje de gran tamaño que impulsan los chatbots de IA, como ChatGPT, Gemini, Claude, etc., tienen requisitos operativos muy elevados debido a su dependencia de GPU con gran capacidad de memoria de video (VRAM). Por esta razón, la mayoría de los modelos de IA están basados en la nube.
El chatbot de inteligencia artificial local se instala directamente en su dispositivo, como cualquier otro software. Esto significa que no necesitas una conexión constante a Internet para usar el chatbot de IA y puedes enviar una solicitud en cualquier momento. DeepSeek-R1 es un gran modelo de lenguaje nativo que se puede instalar en muchos dispositivos. Su modelo destilado 7B (siete mil millones de parámetros) es una versión más pequeña y optimizada que funciona bien en dispositivos de gama media, lo que me permite generar respuestas de IA sin procesamiento en la nube. En términos simples, esto significa respuestas más rápidas, mejor privacidad y control completo sobre mis datos.
Cómo instalar DeepSeek-R1 en una computadora portátil
Ejecutar DeepSeek-R1 en su dispositivo es relativamente simple, pero tenga en cuenta que está utilizando una versión menos potente del chatbot de IA basado en la web de búsqueda profunda. El chatbot de inteligencia artificial de DeepSeek utiliza alrededor de 671 mil millones de parámetros, mientras que contiene DeepSeek-R1 Sobre unos 7 mil millones de parámetros.
Puede descargar y utilizar DeepSeek-R1 en su computadora siguiendo estos pasos:
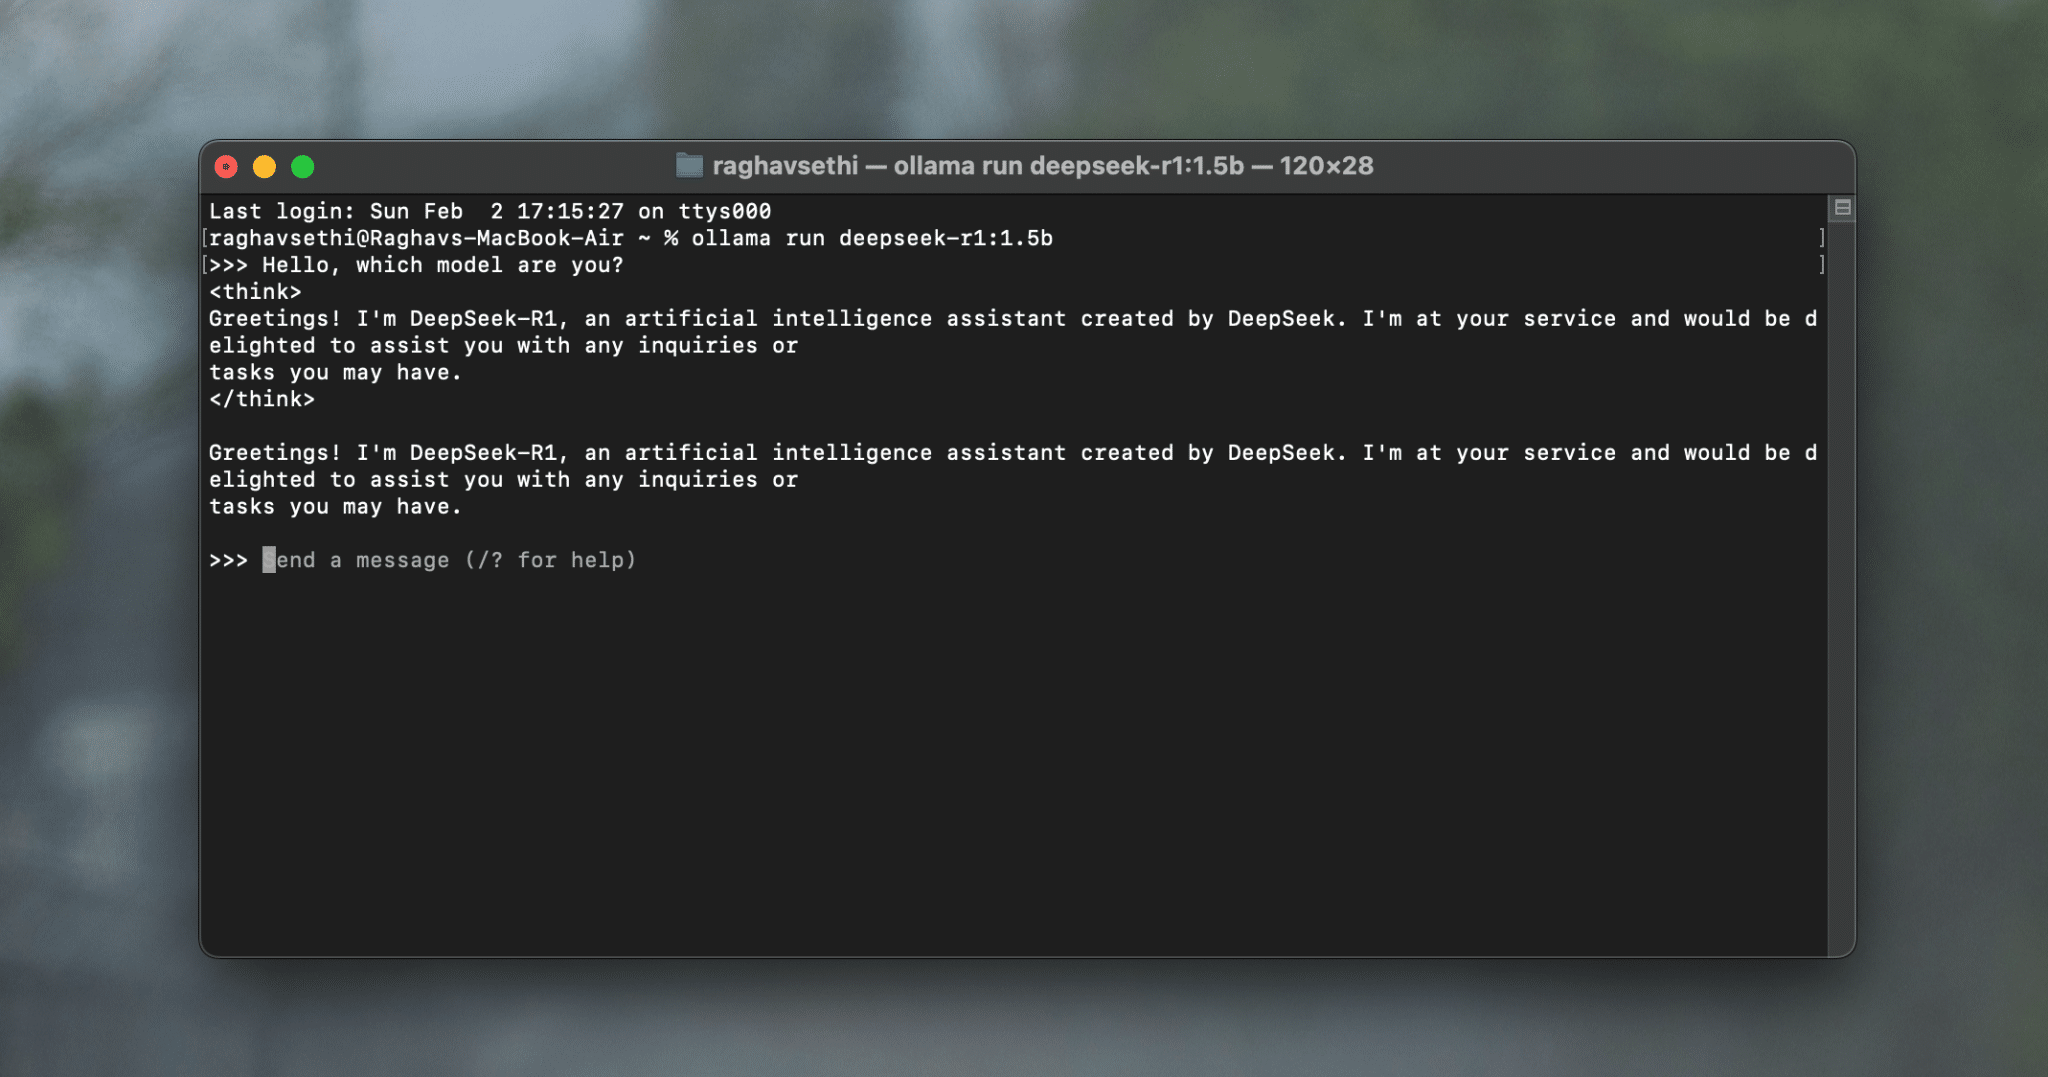
- Ir Sitio web de Ollama Y descarga la última versión. Luego, instálalo en tu dispositivo como cualquier otra aplicación.
- Abra la Terminal y escriba el siguiente comando:
ollama ejecuta deepseek-r1:7b
Esto descargará el modelo DeepSeek-R1 7B a su computadora, lo que le permitirá ingresar consultas en la Terminal y recibir respuestas. Si experimenta problemas de rendimiento o fallas, intente utilizar un modelo menos exigente reemplazando 7b B 1.5b En el orden anterior.
Aunque el modelo funciona bien en la Terminal, si quieres una interfaz de usuario con todas las funciones y un formato de texto adecuado como ChatGPT, también puedes usar una aplicación como Ventana de chat.
Ejecutar DeepSeek localmente no es perfecto, pero funciona
Como se mencionó anteriormente, las respuestas no serán tan buenas (¡ni tan rápidas!) como las del chatbot en línea de DeepSeek, ya que utiliza un modelo más poderoso y procesa todo en la nube. Pero veamos cómo funcionan los modelos más pequeños.
Resolver problemas matemáticos
Para probar el rendimiento del modelo de 7 mil millones de factores, le di una ecuación y le pedí que resolviera su integral. Estuve muy contento con su rendimiento, especialmente porque los modelos básicos a menudo tienen dificultades con las matemáticas. Este experimento demuestra la capacidad de los modelos de lenguaje grandes para manejar problemas de cálculo, lo que resulta muy prometedor en campos como la física y la ingeniería.
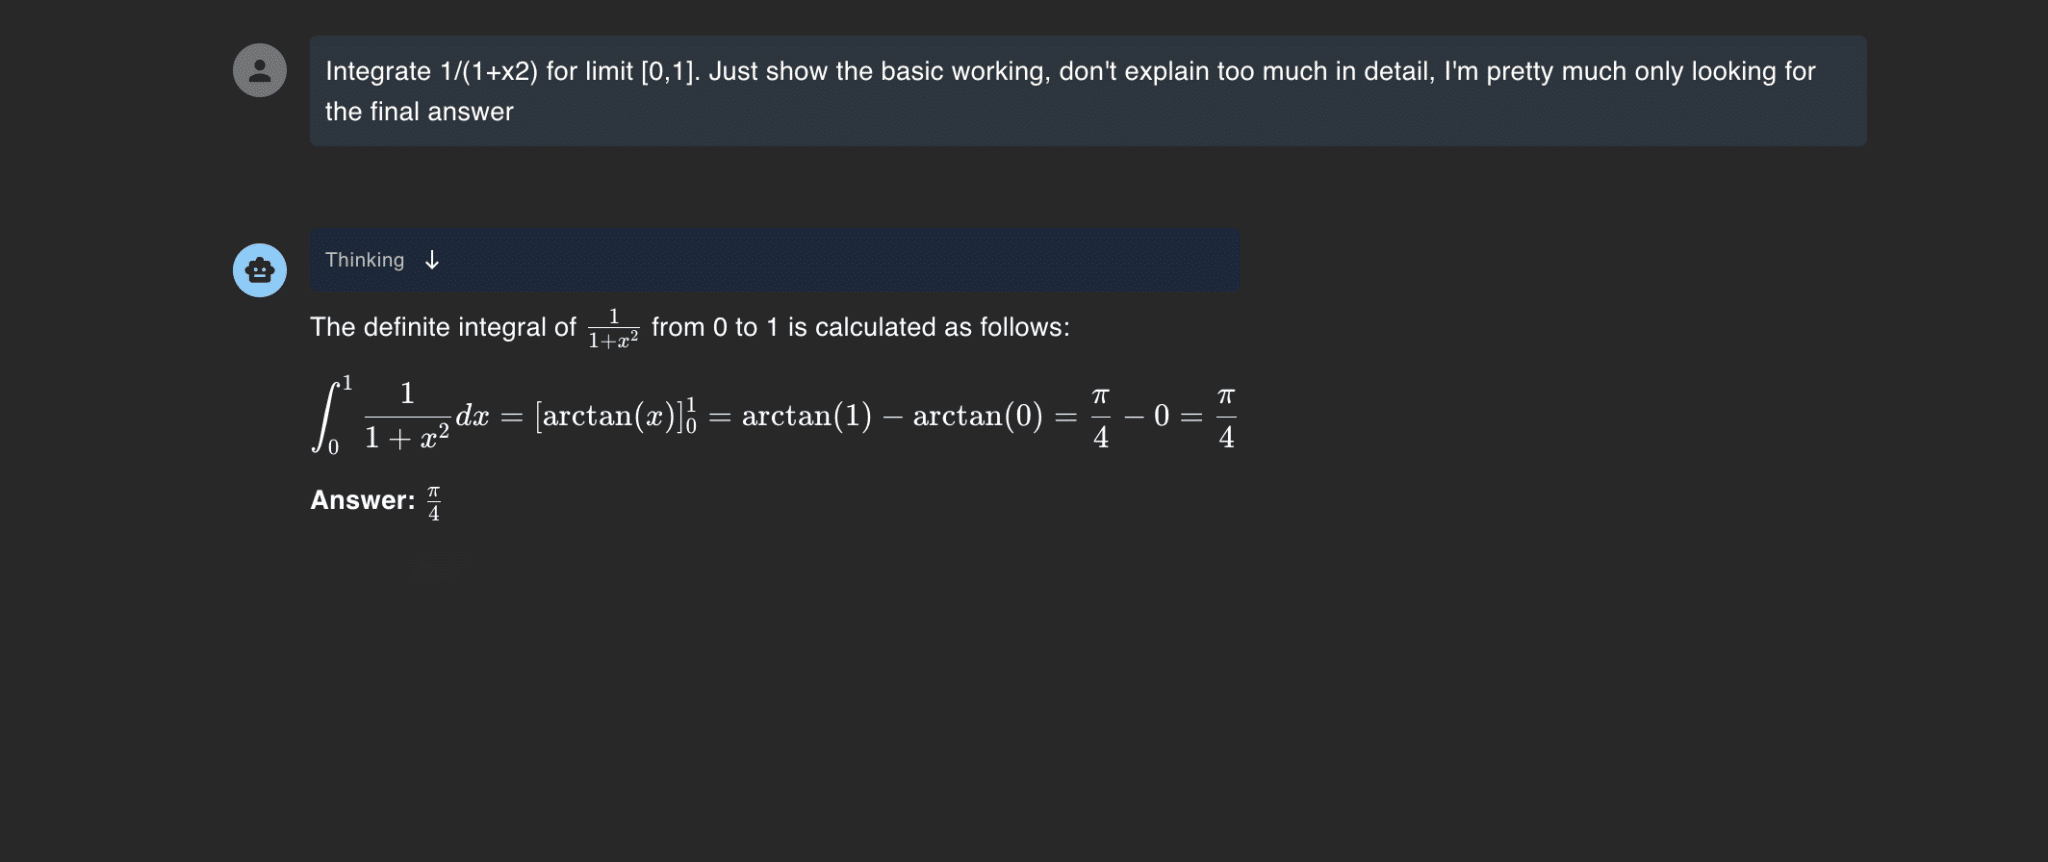
Este no es el problema más complejo, pero es exactamente lo que hace que ejecutar un modelo de lenguaje grande localmente sea tan útil. Se trata de tener una herramienta disponible para gestionar consultas simples al instante en lugar de depender de la nube para todo. Este enfoque mejora la velocidad de respuesta y reduce la dependencia de la conectividad a Internet, lo cual es fundamental en las aplicaciones de IA interactivas.
Corregir errores en el código
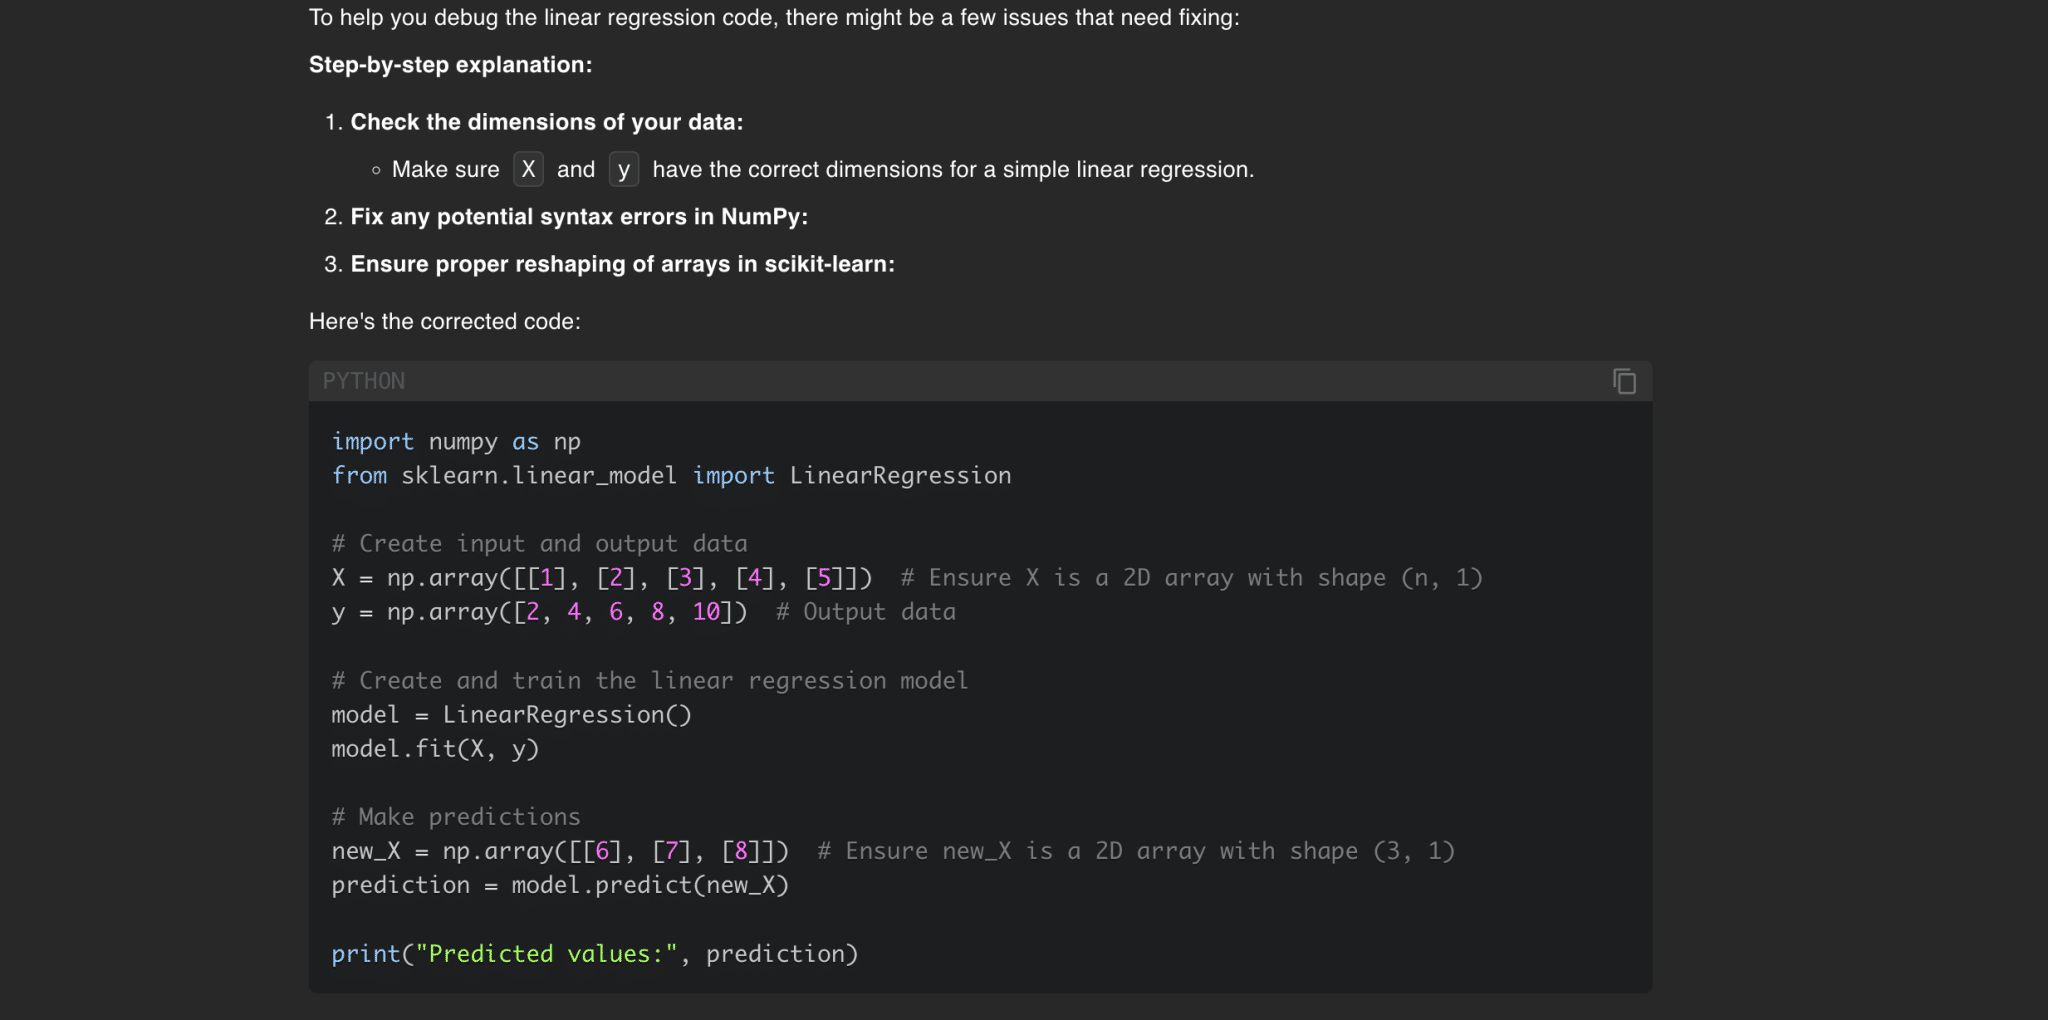
Uno de los mejores usos de ejecutar el modelo DeepSeek-R1 localmente es ayudar con proyectos de IA. Es muy útil, especialmente cuando escribo código en aviones donde no hay acceso a Internet y dependo en gran medida de grandes modelos de lenguaje para la depuración. Para probar su eficacia, le proporcioné este código con un error simple e intencional agregado.
Manejó el código fácilmente, pero vale la pena señalar que lo estaba ejecutando en una MacBook Air M1 con solo 8 GB de memoria unificada. (La memoria unificada es la memoria compartida entre la CPU, la GPU y otras partes de un sistema en un chip).
Con el IDE abierto y varias pestañas del navegador abiertas, el rendimiento de mi MacBook se vio gravemente afectado: tuve que forzar el cierre de todo para que volviera a responder. Si tienes 16 GB de RAM o incluso una GPU de rango medio, probablemente no encontrarás estos problemas.
También lo he probado con bases de código más grandes, pero se queda atascado en un bucle, por lo que no recomendaría confiar en él como un reemplazo completo para modelos más potentes. Sin embargo, sigue siendo útil para crear rápidamente pequeños fragmentos de código.
Resuelve los acertijos
También tenía curiosidad por ver qué tan bien el modelo manejaba los acertijos y el razonamiento lógico, así que lo probé con un problema: sala de montones, lo cual resolví fácilmente, pero realmente comencé a apreciar DeepSeek por otra razón.
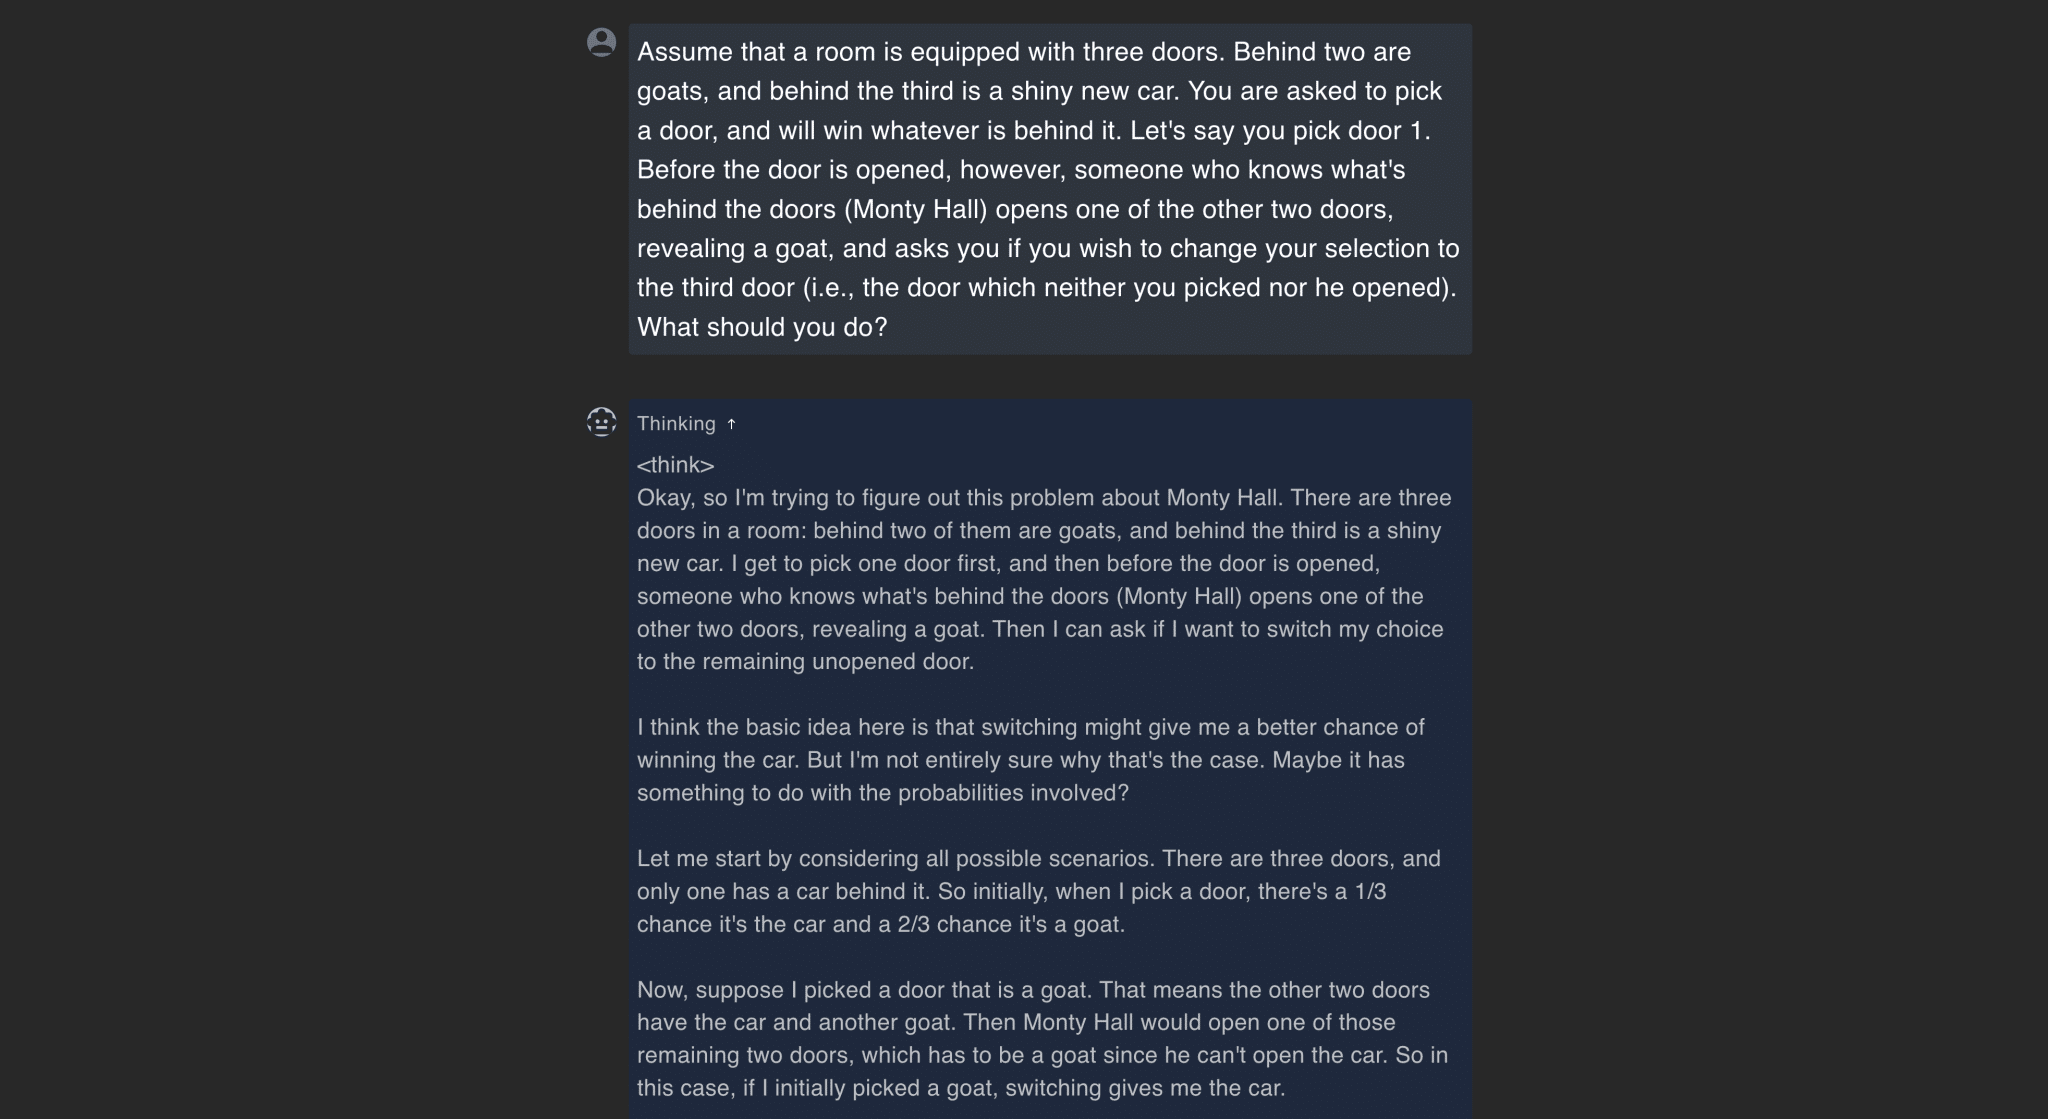
Como se muestra en la imagen, no solo te da la respuesta, sino que te guía a través de todo el proceso de pensamiento, explicando cómo llegó a la solución. Esto demuestra que está pensando en el problema en lugar de simplemente recordar una respuesta memorizada de sus datos de entrenamiento. Esto indica que DeepSeek es capaz de procesar información y deducir soluciones de una manera que imita el pensamiento humano, lo que constituye un paso importante en el desarrollo de modelos de IA.
Búsquedas
Uno de los mayores inconvenientes de ejecutar un modelo de lenguaje grande localmente es la discontinuidad del conocimiento. Como no puede acceder a Internet, puede resultar difícil encontrar información confiable sobre eventos recientes. Esta limitación fue evidente en mis pruebas, pero empeoró cuando pedí una breve descripción general del iPhone original: generó una respuesta inexacta y sin intención de ser divertida.
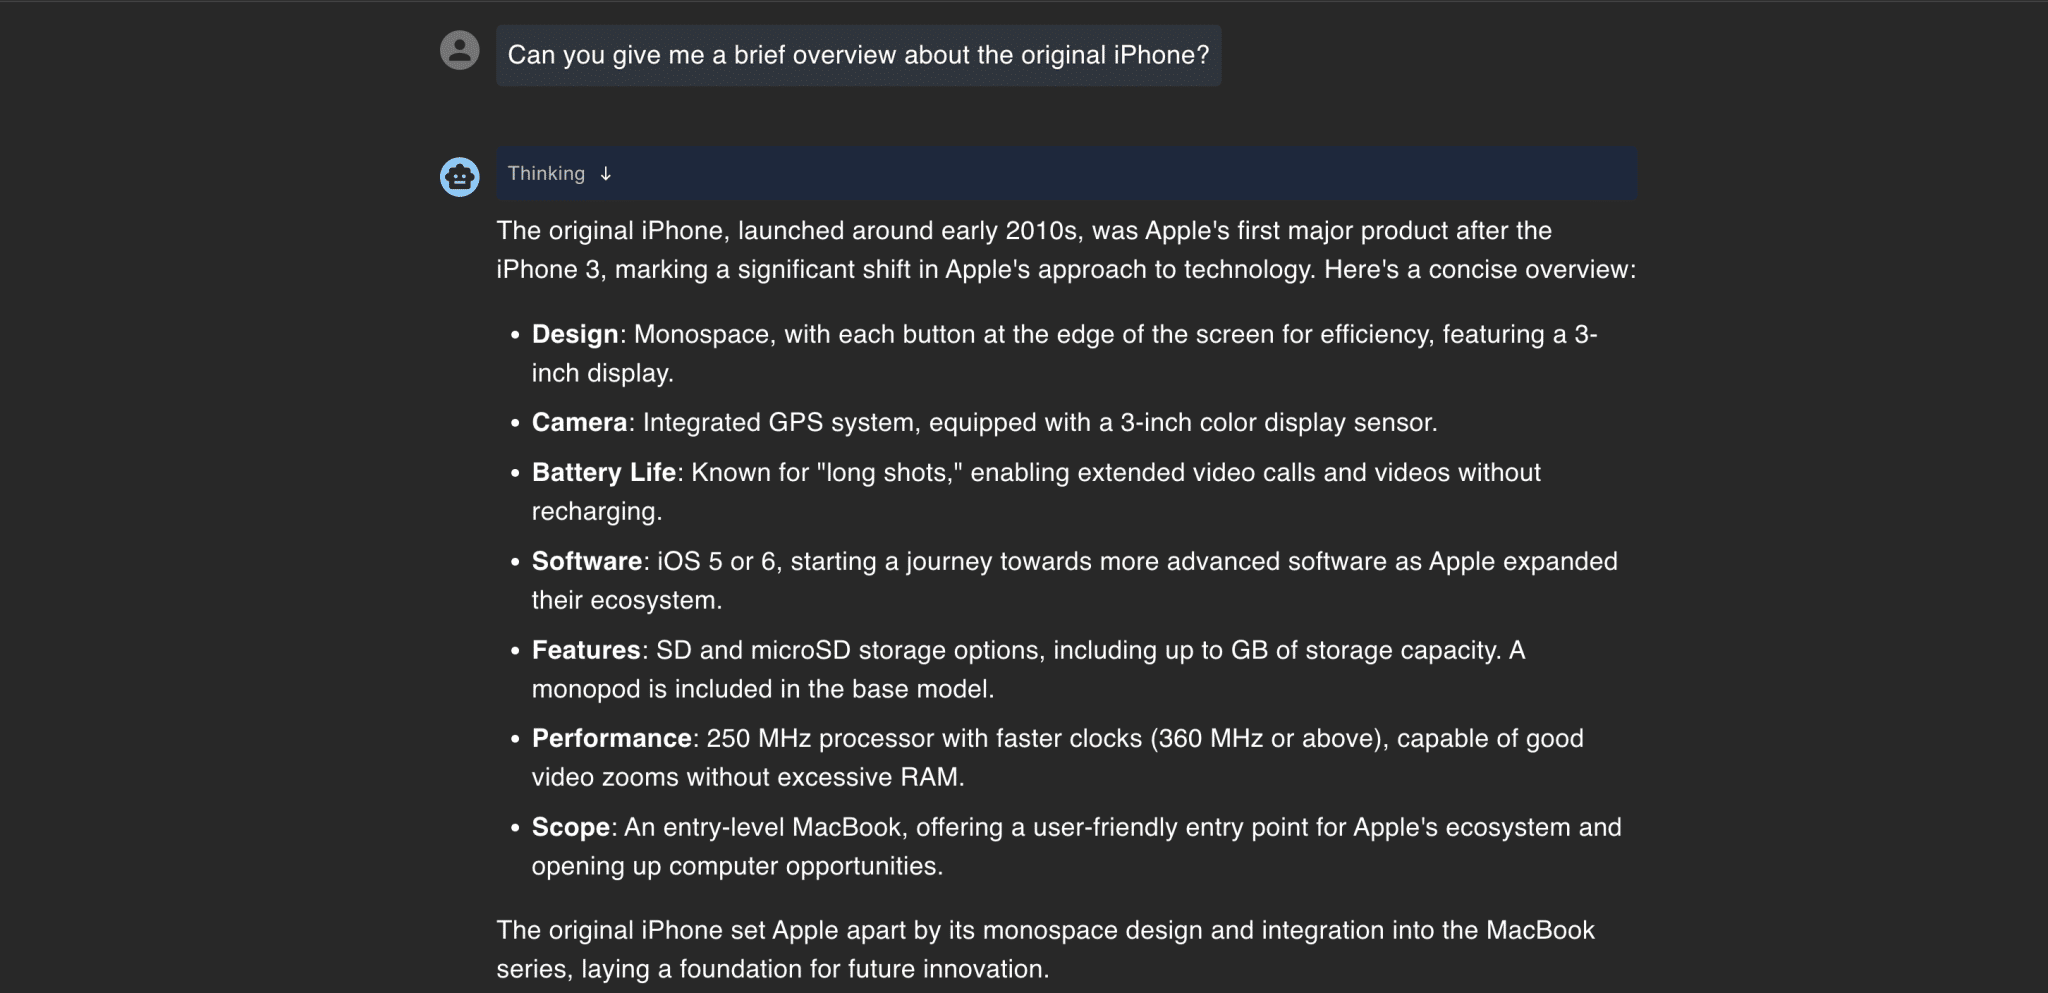
Obviamente el primer iPhone no se lanzó con iOS 5, y el inexistente "iPhone 3" aún no ha llegado. Se equivocó en casi todo. Lo probé con algunas otras preguntas básicas, pero la inexactitud persistió.
بعد Violación de datos de DeepSeekMe sentí tranquilo al saber que podía ejecutar este modelo localmente sin preocuparme de que mis datos se vieran comprometidos. Si bien no es perfecto, tener un asistente de inteligencia artificial sin conexión es una gran ventaja. Me gustaría ver más modelos como este integrados en dispositivos de consumo como teléfonos inteligentes, especialmente después de... Mi decepción con Apple Intelligence.