La mayoría de las herramientas de IA que utilizamos hoy en día se ejecutan en la nube, lo que significa que requieren una conexión constante a internet. Si bien existen opciones para ejecutar herramientas de IA localmente en nuestros dispositivos, se cree que hacerlo requiere hardware potente y costoso.
Eso pensaba yo también, hasta que decidí probar algunas herramientas nativas de IA en una máquina relativamente antigua (una tarjeta gráfica GTX 1070 con casi una década de uso) y descubrí que es realmente posible y eficaz. Este experimento abrió la puerta a nuevas posibilidades para usar la IA incluso en dispositivos con especificaciones modestas, haciendo que esta tecnología sea accesible a un mayor número de usuarios.

Enlaces rápidos
¿Por qué necesitas utilizar un chatbot de IA local?
He usado innumerables chatbots con IA en línea, como ChatGPT, Gemini, Claude y otros. Funcionan de maravilla. Pero ¿qué pasa cuando no tienes conexión a internet y aun así quieres usar un chatbot con IA? ¿O si quieres trabajar en algo muy privado o con información que no se puede divulgar por motivos laborales o de otro tipo?
Esto es cuando necesitas un modelo de lenguaje grande (LLM) local y sin conexión que mantenga todas tus conversaciones y datos en tu dispositivo. Usando Chatbot de IA local Aprovechar el poder de la inteligencia artificial sin depender de una conexión a Internet.
Se considera la privacidad Una de las principales razones para utilizar un modelo de idioma local grande esPero también hay otras razones, como evitar la censura, el uso sin conexión, el ahorro de costes, la personalización, etc. Te proporciona Chatbot de IA local Control total sobre sus datos, garantizando que su información confidencial permanezca segura y protegida.
¿Qué son los modelos de lenguaje grande cuantificados (LLM cuantificados)?
El hardware es el mayor desafío para la mayoría de quienes desean usar modelos de lenguaje grandes (LLM) localmente. Los modelos de IA más potentes requieren un hardware potente para ejecutarse. Además de la facilidad de uso, las limitaciones del hardware son otra razón por la que la mayoría de los chatbots con IA se basan en la computación en la nube.
Las limitaciones de hardware son una de las razones por las que pensé que no podría ejecutar un modelo de lenguaje grande (LLM) de forma nativa. Actualmente tengo una PC bastante modesta, con un procesador AMD Ryzen 5800x (lanzado en 2020), 32 GB de RAM DDR4 y una GPU GTX 1070 (lanzada en 2016). Por lo tanto, no es un hardware de gama alta, pero considerando lo poco que juego últimamente (y cuando lo hago, elijo... Juegos independientes más antiguos que consumen menos recursos) y el alto costo de las GPU modernas, estoy contento con lo que tengo.
Sin embargo, resulta que no es necesario el modelo de IA más potente. Modelos de lenguaje grandes cuantificados (LLM cuantificados) Son modelos de IA que se han hecho más pequeños y rápidos al simplificar los datos que utilizan, específicamente números con punto decimal.
La IA suele operar con números de alta precisión (como decimales de 32 bits), que consumen una cantidad considerable de memoria y potencia de procesamiento. La cuantificación reduce estos números a números de menor precisión (como enteros de 8 bits) sin modificar significativamente el comportamiento del modelo. Esto significa que el modelo se ejecuta más rápido, utiliza menos espacio de almacenamiento y puede ejecutarse en dispositivos más pequeños (como teléfonos inteligentes o periféricos), aunque a veces con una ligera pérdida de precisión.



Esto significa que, si bien mi antiguo hardware seguramente tendría dificultades para ejecutar un modelo de lenguaje grande (LLM) tan poderoso como el Llama 3.1 de 205 mil millones de parámetros, podría ejecutar en su lugar el modelo cuántico de 8B más pequeño.
Y cuando Se anuncia OpenAI Para mis primeros modelos de inferencia ponderados abiertos totalmente cuantificados, pensé que era hora de ver qué tan bien funcionaban en mi antiguo hardware.
¿Cómo uso un modelo de lenguaje grande (LLM) localmente con una tarjeta gráfica Nvidia GTX 1070 y LM Studio?
Me gustaría comenzar esta sección aclarando que no soy experto en modelos de lenguaje local de gran tamaño (LLM) ni en el software que utilicé para ejecutar este modelo inteligente en mi equipo. Lo que presentaré aquí es simplemente una descripción de lo que hice para ejecutar un chatbot inteligente localmente en mi tarjeta gráfica GTX 1070, así como una evaluación de la eficiencia de esta solución. El objetivo es demostrar cómo se puede aprovechar la potencia de procesamiento disponible para ejecutar modelos de IA avanzados sin tener que depender de servicios en la nube.
Descargar LM Studio
Para ejecutar un modelo de lenguaje grande (LLM) localmente, se necesita un software especializado. En concreto, un programa Estudio LM, una herramienta gratuita que te permite descargar y ejecutar modelos LLM localmente en tu dispositivo. Ve a la página de inicio de LM Studio y selecciona Descargar para [sistema operativo] (Utilizo Windows 10). LM Studio es una plataforma ideal para desarrolladores e investigadores que desean experimentar con diferentes modelos de lenguaje grandes y evaluar su rendimiento en sus máquinas personales antes de implementarlos.
Este es un proceso de instalación estándar de Windows. Ejecute el programa de instalación, complete la instalación y luego inicie LM Studio. Recomiendo elegir Usuario avanzado Porque revela algunas opciones útiles que quizás quieras explorar. Esta opción proporciona un mayor control sobre la configuración del programa y opciones avanzadas para personalizar la experiencia de uso de los modelos LLM. Con LM Studio, puedes explorar el mundo de los grandes modelos lingüísticos de forma fácil y eficiente.
Descarga tu primer modelo de IA local
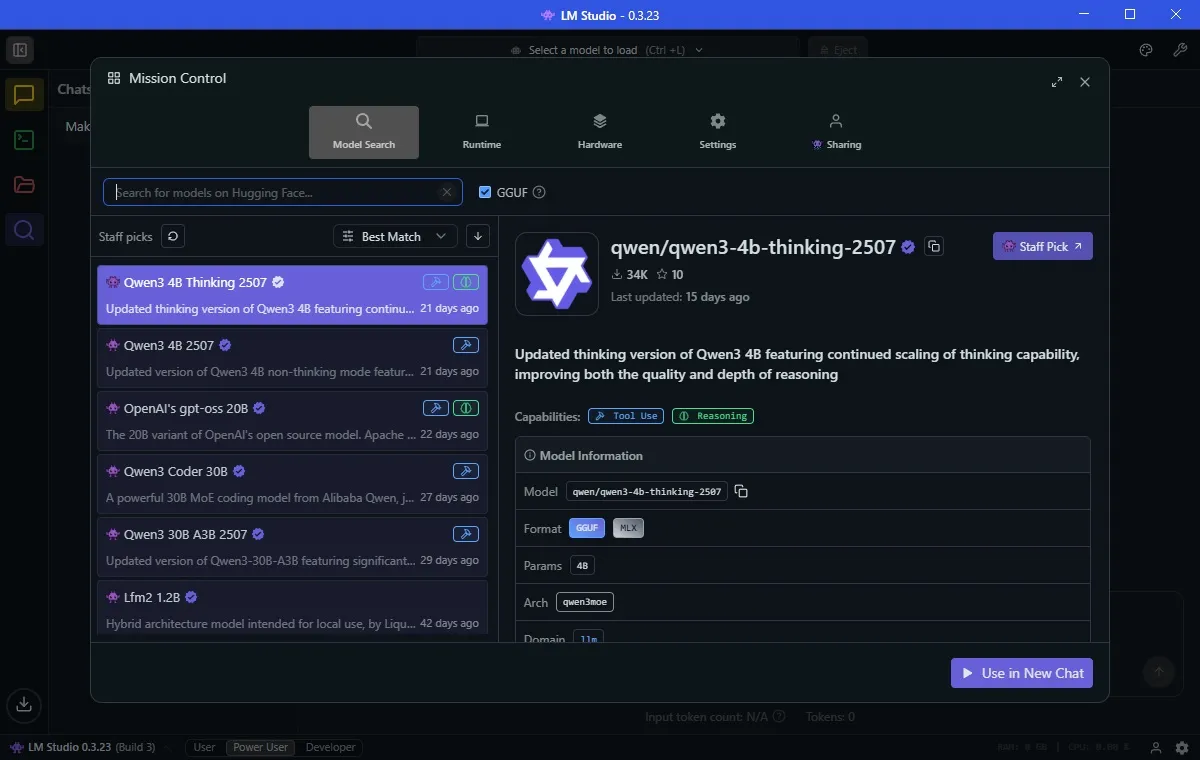
Tras la instalación, puede cargar su primer modelo de lenguaje grande (LLM). Seleccione la pestaña Descubre (Icono de lupa). LM Studio muestra fácilmente los modelos de IA nativos que funcionarán mejor en su dispositivo.
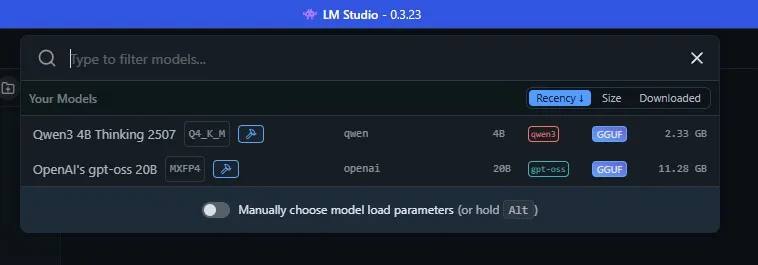
En mi caso, sugiere descargar una plantilla llamada Qwen 3-4b-pensamiento-2507El nombre del modelo es Qwen (Desarrollado por el gigante tecnológico chino Alibaba), que es la tercera versión de este modelo. El valor "4b" significa que este modelo cuenta con cuatro mil millones de parámetros para responder, mientras que "pensando" significa que este modelo dedicará tiempo a considerar su respuesta antes de responder. Finalmente, 2507 es la última actualización de este modelo, el 25 de julio.
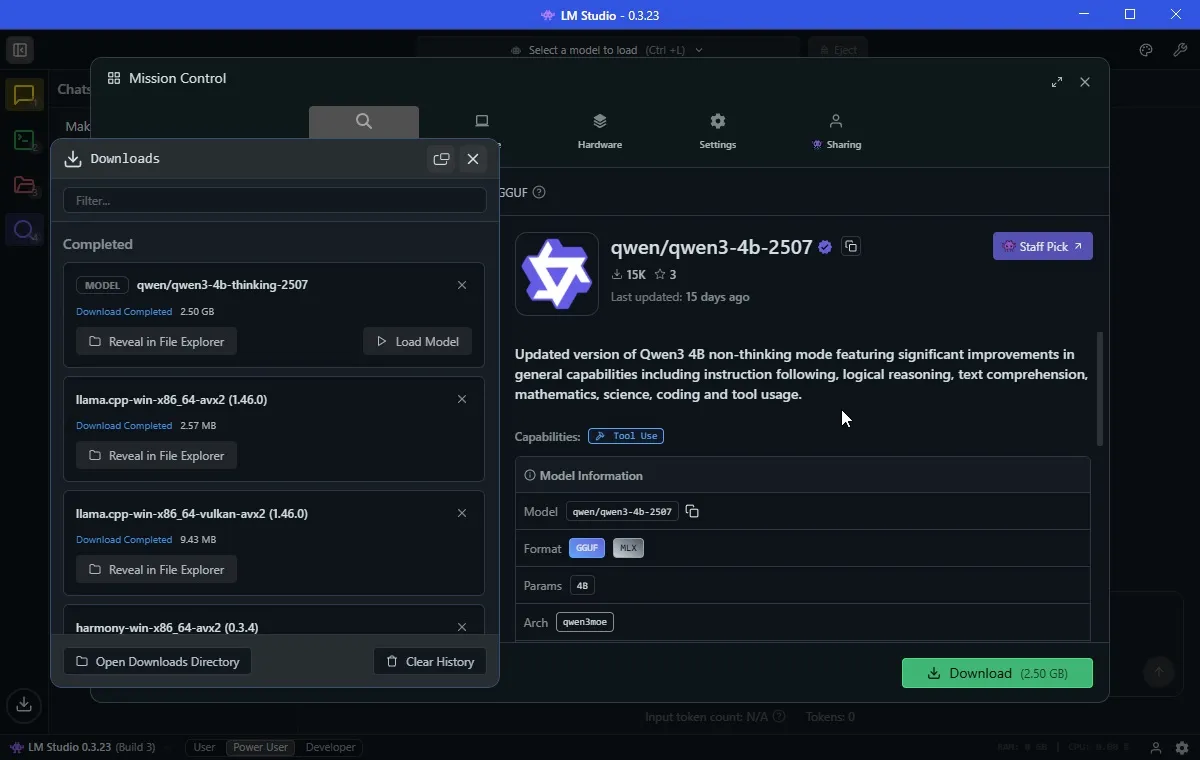
Qwen3-4b-thinking ocupa solo 2.5 GB, por lo que no debería tardar mucho en descargarse. También descargué previamente OpenAI/gpt-oss-20b, que ocupa 12.11 GB y tiene un tamaño mayor. Además, incluye 20 XNUMX millones de parámetros, por lo que debería proporcionar mejores respuestas, aunque su consumo de recursos será mayor.
Ahora, aparte de Las complejidades de la denominación de modelos de IAUna vez que descargue LLM, estará casi listo para comenzar a usarlo.
Antes de ejecutar el modelo de IA, vaya a la pestaña Hardware Asegúrese de que LM Studio identifique correctamente su sistema. También puede desplazarse hacia abajo y ajustar Las barandillas Aquí. He configurado los firewalls en mi computadora para Equilibrado, evitando que cualquier modelo de IA consuma demasiados recursos, lo que podría causar una sobrecarga del sistema.
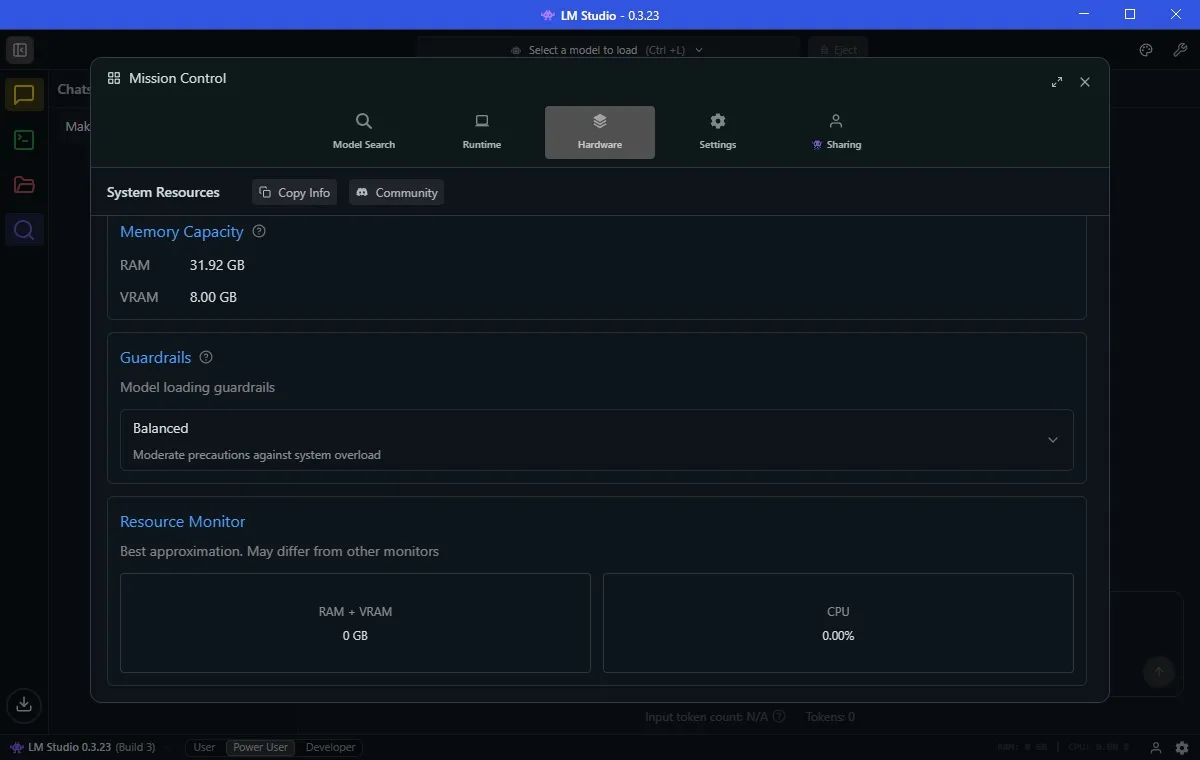
También notarás Monitor de recursos Debajo de las barandillas. Esta es una forma sencilla de ver cuánto uso del sistema consume tu modelo de IA. Vale la pena monitorearlo si usas hardware limitado como yo, ya que no quieres que tu sistema se bloquee inesperadamente.
Sube tu modelo de IA y comienza a usarlo.
Ya está listo para empezar a usar su chatbot de IA localmente en su dispositivo. En LM Studio, seleccione la barra superior, que funciona como herramienta de búsqueda. Al seleccionar el nombre de la IA, este se cargará en la memoria de su ordenador y podrá empezar a introducir comandos y preguntas. Este proceso es necesario para habilitar las funciones del modelo de lenguaje grande (LLM) directamente en su dispositivo, lo que le permite experimentar la IA de forma interactiva y rápida sin necesidad de una conexión a internet constante. Recuerde que el rendimiento del modelo depende de las especificaciones de su dispositivo, así que asegúrese de tener suficientes recursos para ejecutarlo eficientemente.
Ejecutar un modelo de IA localmente en hardware más antiguo: excelente, pero con limitaciones
Ejecutar un modelo de IA localmente te permite aprovecharlo de la forma habitual, pero debes tener en cuenta algunas limitaciones importantes. Estos modelos locales, si bien son útiles, no son tan potentes como los modelos de vanguardia como GPT-5, utilizado en ChatGPT. Además, notarás que el proceso de pensamiento y respuesta es mucho más largo, y la calidad de las respuestas puede variar significativamente.
Para ilustrarlo, probé un modelo de lenguaje grande (LLM) clásico tanto en Qwen como en gpt-oss, y ambos lograron completar la tarea, aunque tras una larga espera. Esto demuestra que usar un modelo de IA nativo en una máquina antigua puede ser una solución práctica, pero requiere paciencia y comprender las limitaciones del hardware antiguo.
Allen, Bob, Colin, Dave y Emily están de pie en círculo. Allen está a la izquierda de Bob. Bob está a la izquierda de Colin. Colin está a la izquierda de Dave. Dave está a la izquierda de Emily. ¿Quién está a la derecha de Allen?
Qwen tardó 5 minutos y 11 segundos en llegar a la conclusión correcta. GPT-5 solo tardó unos 45 segundos. ¿Pero quién superó a todos? gpt-oss-20b con un tiempo récord de 31 segundos.
Una sola prueba no es suficiente, así que lo probé con otro rompecabezas diseñado para evaluar las habilidades de razonamiento de la IA. En una prueba anterior, el último modelo de OpenAI, GPT-5, no pasó esta prueba, así que estaba ansioso por ver cómo lo gestionaban las versiones sin conexión de Qwen y gpt-oss.
Análisis del desempeño de los modelos de inteligencia artificial en la resolución de problemas lógicos
La capacidad de resolver problemas lógicos supone un verdadero reto para los modelos de IA. El ejemplo anterior, que implica identificar relaciones espaciales entre un grupo de personas, ilustra la variabilidad del rendimiento de estos modelos.
Relaciones espaciales y los desafíos de la inteligencia artificial
El procesamiento de relaciones espaciales es fundamental para la inteligencia artificial, ya que requiere un profundo conocimiento del lenguaje y la capacidad de razonar lógicamente. El ejemplo anterior demuestra que algunos modelos, como gpt-oss-20b, destacan en esta tarea, mientras que otros, como Qwen y GPT-5, tardan más en llegar a la solución correcta.
La importancia de diversas pruebas para evaluar la inteligencia artificial
Ninguna prueba por sí sola puede evaluar exhaustivamente las capacidades de la IA. Es necesario realizar diversas pruebas que cubran diferentes aspectos de la inteligencia, como el razonamiento lógico, la comprensión del lenguaje y la resolución de problemas complejos. Esto permite una evaluación más precisa de las capacidades y limitaciones de cada modelo.
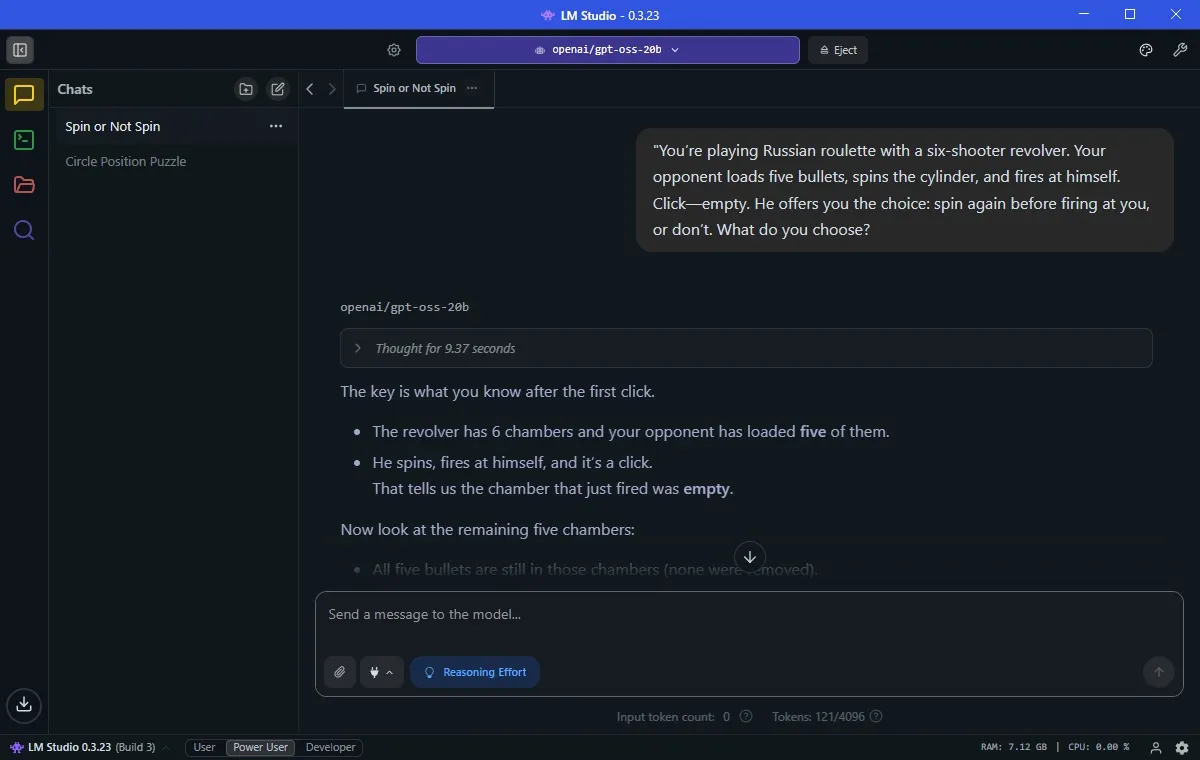
Imagina que estás jugando a la ruleta rusa con una pistola de seis cartuchos. Tu oponente carga cinco balas, gira el tambor y se dispara. "Tick" significa vacío. Entonces te ofrece una opción: ¿Quieres girar el tambor de nuevo antes de que te dispare o no? ¿Qué eliges?
El modelo Qwen logró dar la respuesta correcta en 41 minuto y 5 segundos, un tiempo muy bueno (considerando las limitaciones del hardware). Sin embargo, sorprendentemente, GPT-20 no logró resolver este problema, lo cual es realmente sorprendente. Incluso me ofreció una gráfica que mostraba su acierto. Una vez más, gpt-oss-9b acertó en tan solo XNUMX segundos.
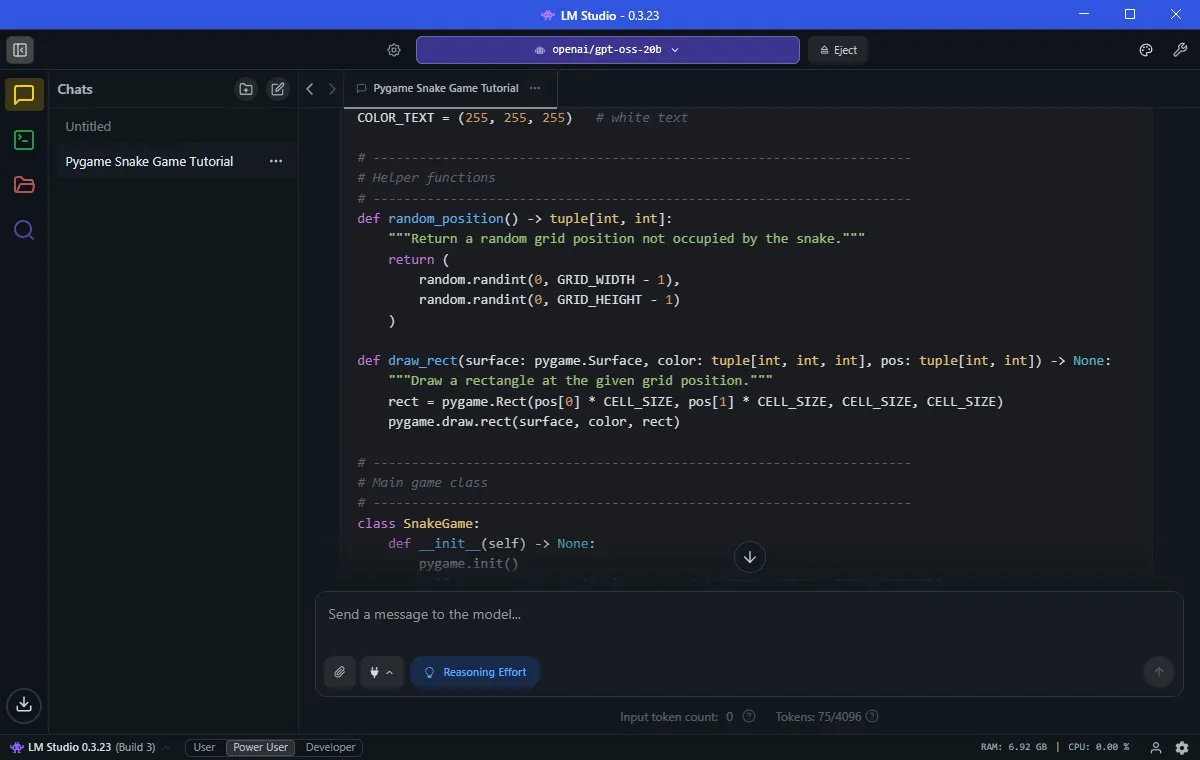
En otras áreas, también obtuve un éxito inmediato. Le pedí a gpt-oss que me escribiera un juego de serpiente con Pygame, y en un par de minutos, tenía un juego de serpiente completamente funcional. Esto demuestra la capacidad del modelo para generar juegos eficientemente.
Ejecutar un modelo de IA en sus dispositivos antiguos
La clave para ejecutar un modelo de lenguaje grande (LLM) de forma nativa en hardware antiguo reside en elegir el modelo de IA adecuado para las capacidades de su hardware. Si bien la versión de Qwen tuvo un buen rendimiento y fue la mejor opción en LM Studio, el modelo gpt-oss-20b de OpenAI es claramente una opción muy superior.
Pero es importante equilibrar tus expectativas. Si bien gpt-oss respondió las preguntas con precisión (y más rápido que GPT-5), no podré procesar una gran cantidad de datos. Las limitaciones de mi hardware se harán evidentes rápidamente.
Antes de probarlo, estaba convencido de que ejecutar un chatbot de IA nativo en mi antiguo hardware era imposible. Pero gracias a modelos cuánticos y herramientas como LM Studio, no solo es posible, sino sorprendentemente útil.
Sin embargo, no obtendrá la misma velocidad, precisión ni profundidad de razonamiento que con algo como GPT-5 en la nube. Ejecutar localmente implica ciertas desventajas: gana privacidad, acceso sin conexión y control sobre sus datos, pero sacrifica rendimiento.
Sin embargo, el hecho de que una GPU de siete años y una CPU de cuatro puedan manejar la IA moderna es muy emocionante. Si tienes dudas porque no tienes hardware de alta gama, no te preocupes: los modelos cuánticos locales pueden ser tu camino hacia la IA offline. Usa el modelo de IA adecuado para sacar el máximo provecho de tu hardware antiguo.